# Unbalanced disk usage - ES 2.1
**URL:** https://discuss.elastic.co/t/unbalanced-disk-usage-es-2-1/131219
**Category:** Elasticsearch
**Created:** [May 9, 2018, 7:03pm UTC](https://discuss.elastic.co/t/unbalanced-disk-usage-es-2-1/131219 "2018-05-09T19:03:45Z")
**Posts on this page:** 20
**Page:** 1
### Author:  [@varun\_arora](https://discuss.elastic.co/u/varun_arora)
#### Post date: [May 9, 2018, 7:03pm UTC](https://discuss.elastic.co/t/unbalanced-disk-usage-es-2-1/131219/1 "2018-05-09T19:03:45Z")
On a 5 node cluster, the shards are balanced, but the disk space used is unbalanced. Checking the directories, I found that the shards are taking around 10 times the size of the shard on the disk.
//tickets\_v2 2 p STARTED 1688677 30.5gb 10.14.23.210 Occulus
tickets\_v2 2 r STARTED 1688677 28.9gb 10.14.66.191 Lila Cheney
tickets\_v2 4 p STARTED 1690046 34.6gb 10.14.66.191 Lila Cheney
tickets\_v2 4 r STARTED 1690046 30.1gb 10.14.17.10 Equinox
tickets\_v2 1 r STARTED 1687292 26.9gb 10.14.23.210 Occulus
tickets\_v2 1 p STARTED 1687292 30.1gb 10.14.23.34 Cowgirl
tickets\_v2 3 p STARTED 1688535 31.3gb 10.14.65.216 Mastermind
tickets\_v2 3 r STARTED 1688535 27.9gb 10.14.17.10 Equinox
tickets\_v2 0 r STARTED 1688199 28.6gb 10.14.65.216 Mastermind
tickets\_v2 0 p STARTED 1688198 30.2gb 10.14.23.34 Cowgirl
root@elasticsearch2:/data/elasticsearch/touch/nodes/0/indices/tickets\_v2# du -sh \*
299G 3
300G 4
8.0K \_state
On the other node it is -
root@elasticsearch1:/data/elasticsearch/touch/nodes/0/indices/tickets\_v2# du -sh \*
28G 1
302G 2
8.0K \_state
Why would this be? and any solutions to this ?
---
### Author:  [@warkolm](https://discuss.elastic.co/u/warkolm)
#### Post date: [May 10, 2018, 6:08am UTC](https://discuss.elastic.co/t/unbalanced-disk-usage-es-2-1/131219/2 "2018-05-10T06:08:32Z")
Elasticsearch only balances by shard count, not size.
---
### Author:  [@Christian\_Dahlqvist](https://discuss.elastic.co/u/Christian_Dahlqvist)
#### Post date: [May 10, 2018, 6:28am UTC](https://discuss.elastic.co/t/unbalanced-disk-usage-es-2-1/131219/3 "2018-05-10T06:28:38Z")
That looks like a big difference. Are all nodes running exactly the same version?
---
### Author:  [@varun\_arora](https://discuss.elastic.co/u/varun_arora)
#### Post date: [May 10, 2018, 9:06am UTC](https://discuss.elastic.co/t/unbalanced-disk-usage-es-2-1/131219/4 "2018-05-10T09:06:01Z")
Yes.. all are running the same version - 2.1.1
---
### Author:  [@Christian\_Dahlqvist](https://discuss.elastic.co/u/Christian_Dahlqvist)
#### Post date: [May 10, 2018, 9:21am UTC](https://discuss.elastic.co/t/unbalanced-disk-usage-es-2-1/131219/5 "2018-05-10T09:21:04Z")
Based on the shard listing it looks like data is evenly distributed across the nodes as each node have 2 shards that are all similar in size.
---
### Author:  [@varun\_arora](https://discuss.elastic.co/u/varun_arora)
#### Post date: [May 10, 2018, 10:51am UTC](https://discuss.elastic.co/t/unbalanced-disk-usage-es-2-1/131219/6 "2018-05-10T10:51:26Z")
Yes, would adding nodes and relocating them to the new one help ? or is it jus the movement of shards from the disk to the other node ?
Any other way you could see to alleviate this ?
Could it be something in 2.x? We have not seen this issue with 5.x
---
### Author:  [@varun\_arora](https://discuss.elastic.co/u/varun_arora)
#### Post date: [May 10, 2018, 11:13am UTC](https://discuss.elastic.co/t/unbalanced-disk-usage-es-2-1/131219/7 "2018-05-10T11:13:28Z")
Would the merge api help here ?
What I see in newrelic plugin is that number of documents is same on all boxes.
---
### Author:  [@Christian\_Dahlqvist](https://discuss.elastic.co/u/Christian_Dahlqvist)
#### Post date: [May 10, 2018, 11:15am UTC](https://discuss.elastic.co/t/unbalanced-disk-usage-es-2-1/131219/8 "2018-05-10T11:15:57Z")
What does `GET /_nodes/stats/indices` give?
---
### Author:  [@varun\_arora](https://discuss.elastic.co/u/varun_arora)
#### Post date: [May 10, 2018, 11:27am UTC](https://discuss.elastic.co/t/unbalanced-disk-usage-es-2-1/131219/9 "2018-05-10T11:27:55Z")
Any place where I can paste the output ? Its too long
---
### Author:  [@Christian\_Dahlqvist](https://discuss.elastic.co/u/Christian_Dahlqvist)
#### Post date: [May 10, 2018, 11:45am UTC](https://discuss.elastic.co/t/unbalanced-disk-usage-es-2-1/131219/10 "2018-05-10T11:45:58Z")
Put it in a gist and link to it here.
---
### Author:  [@varun\_arora](https://discuss.elastic.co/u/varun_arora)
#### Post date: [May 10, 2018, 11:53am UTC](https://discuss.elastic.co/t/unbalanced-disk-usage-es-2-1/131219/11 "2018-05-10T11:53:13Z")
Here it is :
>
---
### Author:  [@Christian\_Dahlqvist](https://discuss.elastic.co/u/Christian_Dahlqvist)
#### Post date: [May 10, 2018, 12:00pm UTC](https://discuss.elastic.co/t/unbalanced-disk-usage-es-2-1/131219/12 "2018-05-10T12:00:32Z")
Based on that the data seems reasonably evenly distributed across the nodes.
---
### Author:  [@varun\_arora](https://discuss.elastic.co/u/varun_arora)
#### Post date: [May 10, 2018, 12:13pm UTC](https://discuss.elastic.co/t/unbalanced-disk-usage-es-2-1/131219/13 "2018-05-10T12:13:47Z")
Any suggestions to alleviate this? New node addition ? relocation of shards? or merge api ?
I am running out of ideas.
---
### Author:  [@Christian\_Dahlqvist](https://discuss.elastic.co/u/Christian_Dahlqvist)
#### Post date: [May 10, 2018, 12:33pm UTC](https://discuss.elastic.co/t/unbalanced-disk-usage-es-2-1/131219/14 "2018-05-10T12:33:12Z")
I do not see what the problem is. Distribution seems even across the nodes.
---
### Author:  [@varun\_arora](https://discuss.elastic.co/u/varun_arora)
#### Post date: [May 10, 2018, 2:01pm UTC](https://discuss.elastic.co/t/unbalanced-disk-usage-es-2-1/131219/15 "2018-05-10T14:01:51Z")
Any other clue why the disk usage would be bloated for any shard ? Do you think its an issue related to 2.x ?
---
### Author:  [@Christian\_Dahlqvist](https://discuss.elastic.co/u/Christian_Dahlqvist)
#### Post date: [May 10, 2018, 2:20pm UTC](https://discuss.elastic.co/t/unbalanced-disk-usage-es-2-1/131219/16 "2018-05-10T14:20:58Z")
I do not know as I have not used version 2.x in quite some time. It may help if you can identify which types of files that make up the difference.
---
### Author:  [@Wedney\_Yuri](https://discuss.elastic.co/u/Wedney_Yuri)
#### Post date: [May 10, 2018, 2:23pm UTC](https://discuss.elastic.co/t/unbalanced-disk-usage-es-2-1/131219/17 "2018-05-10T14:23:30Z")
Hi @Christian_Dahlqvist,
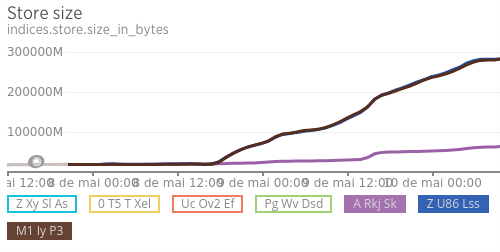
I'm experiencing a similar issue in elasticsearch 6.2.3. The shard size is not equal across nodes.
The primary node shard is using 57.8gb of storage while the replicas are using 264.5gb.
---
### Author:  [@Wedney\_Yuri](https://discuss.elastic.co/u/Wedney_Yuri)
#### Post date: [May 10, 2018, 2:28pm UTC](https://discuss.elastic.co/t/unbalanced-disk-usage-es-2-1/131219/18 "2018-05-10T14:28:16Z")
In the graph below you can see the difference between the master and the replicas. This index contains only one shard.
elasticsearch.yml:
```
cluster.name: ${CLUSTER_NAME}
cluster.routing.allocation.awareness.attributes: aws_availability_zone
cloud.node.auto_attributes: true
plugin.mandatory: discovery-ec2,repository-s3
transport.tcp.compress: true
indices.queries.cache.size: 30%
indices.requests.cache.size: 20%
indices.memory.index_buffer_size: 20%
indices.memory.max_index_buffer_size: 512mb
action.auto_create_index: false
action.destructive_requires_name: true
node.master: ${ES_NODE_MASTER}
node.data: ${ES_NODE_DATA}
bootstrap.memory_lock: true
network.host: 0.0.0.0
http.cors.enabled: true
http.cors.allow-origin: '*'
discovery.zen.minimum_master_nodes: ${SPLIT_BRAIN_NODES}
discovery.ec2.tag.cluster: ${CLUSTER_NAME}
discovery.ec2.endpoint: ec2.${AWS_REGION}.amazonaws.com
discovery.zen.ping_timeout: 30s
discovery.zen.hosts_provider: ec2
```
---
### Author:  [@varun\_arora](https://discuss.elastic.co/u/varun_arora)
#### Post date: [May 10, 2018, 4:19pm UTC](https://discuss.elastic.co/t/unbalanced-disk-usage-es-2-1/131219/19 "2018-05-10T16:19:25Z")
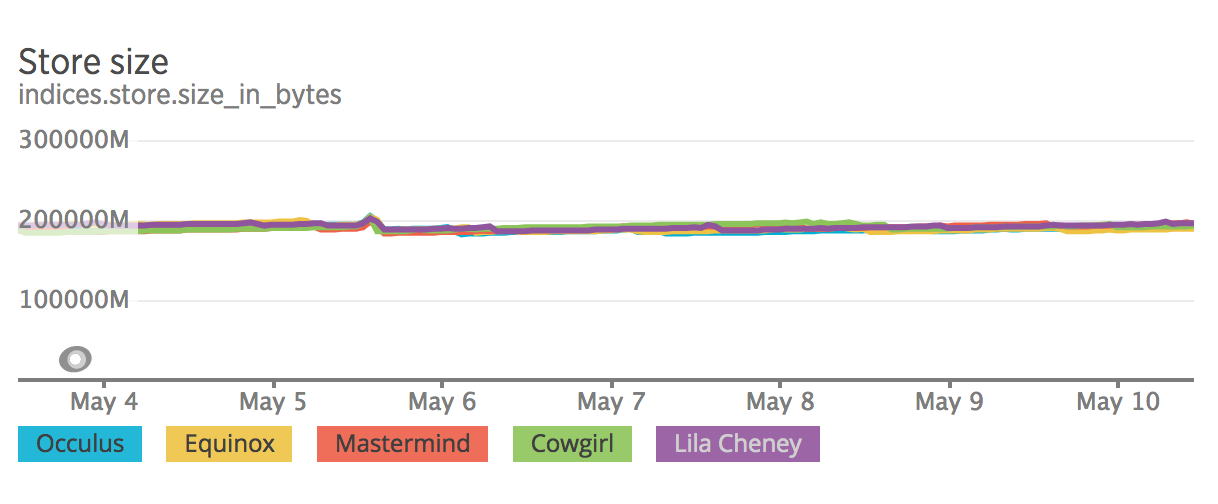
In my case, even that is same :
---
### Author:  [@varun\_arora](https://discuss.elastic.co/u/varun_arora)
#### Post date: [May 10, 2018, 6:22pm UTC](https://discuss.elastic.co/t/unbalanced-disk-usage-es-2-1/131219/20 "2018-05-10T18:22:49Z")
I found the issue affecting me. Its the translog that is not being flushed.
root@elasticsearch1:/data/elasticsearch/touch/nodes/0/indices/tickets\_v2/2# du -sh \*
33G index
4.0K \_state
282G translog
Related to this bug : [https://github.com/elastic/elasticsearch/pull/15830](https://github.com/elastic/elasticsearch/pull/15830)
@Christian_Dahlqvist : Shall I flush it with (POST /tickets\_v2/\_flush) ? What will be its effect on the application? Would the other indices continue to serve ?
[Next page](https://discuss.elastic.co/t/unbalanced-disk-usage-es-2-1/131219.md?page=2)